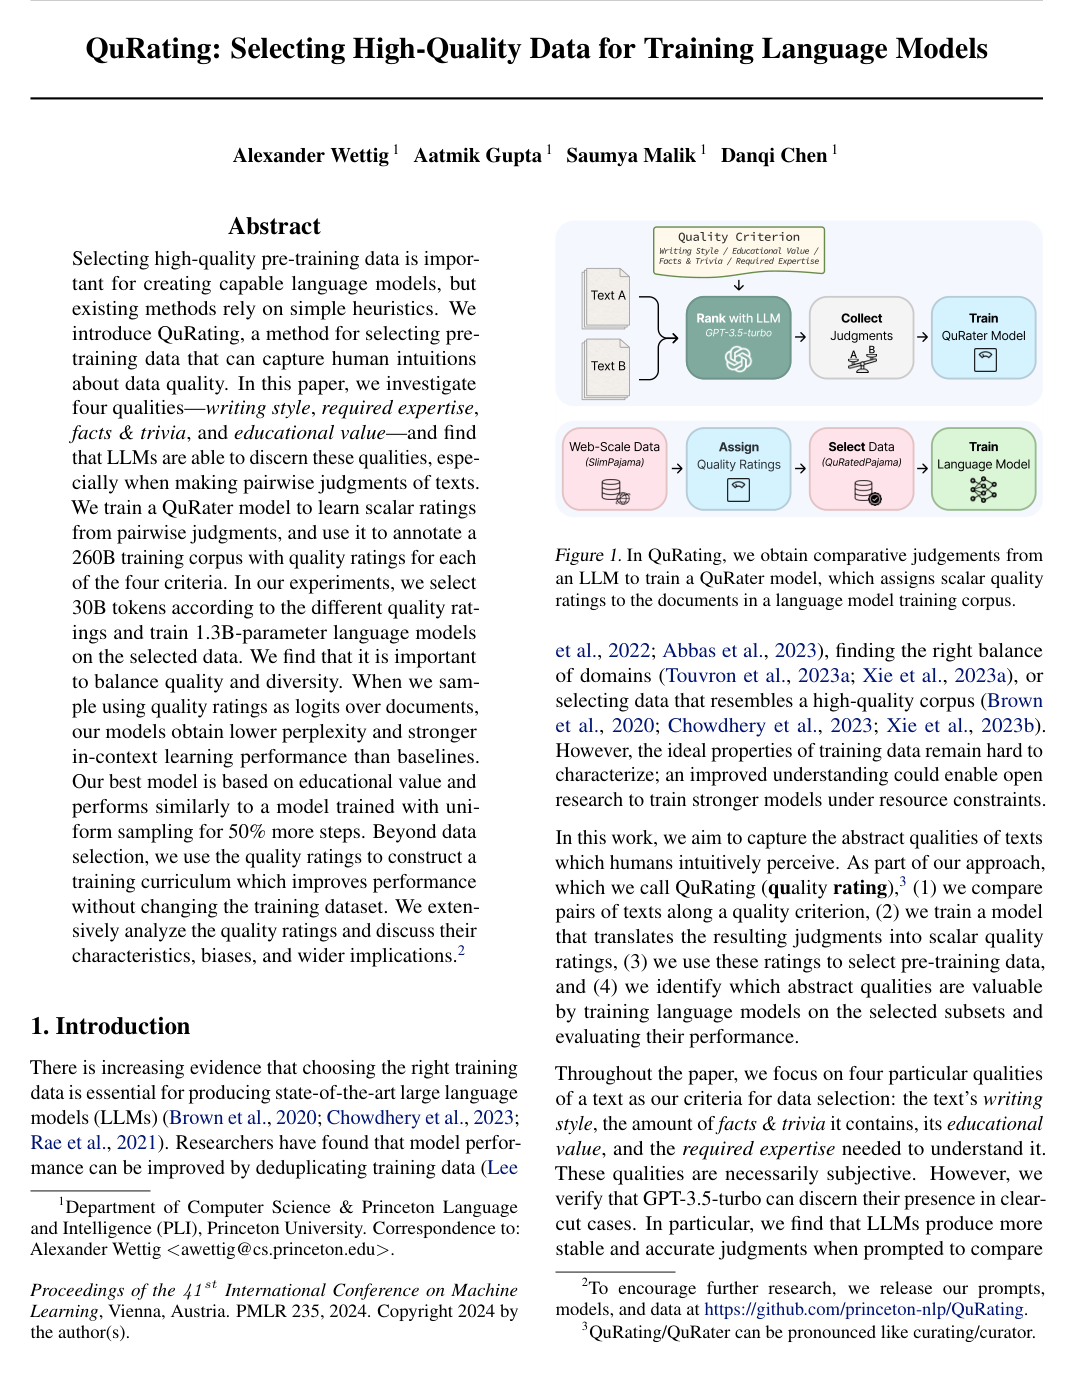
QuRating is a machine learning framework for evaluating and selecting high-quality pre-training data for language models based on criteria that align with human judgments. The approach utilizes a trained rating model that converts pairwise text comparisons into scalar scores across multiple quality dimensions, such as writing style, required expertise, factual knowledge, and educational value. These learned ratings are used to balance content quality and dataset diversity, facilitating targeted document sampling, data filtering, and curriculum learning strategies that improve language model training efficiency and downstream task performance.